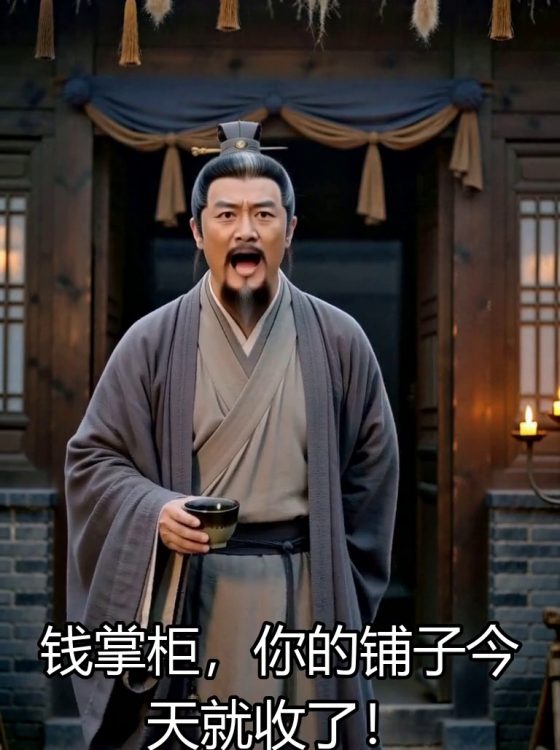
个人起步
一个人先跑通流程
- 1 个专属形象
- 1 个复刻音色
- 每月若干条成片额度
- 1080P 输出
- 模板库基础权限
成片可以直接投到这些渠道
形象、声音、口型、编排、批量、协作,过去分散在拍摄、录音、剪辑、审核几套流程里做。 在这里它们是同一份工程里的几个面板,不用来回导文件。
一段 30 秒自拍即可重建面部动态模型,保留微表情与头部转动习惯,无需专业采集棚。
朗读 8 句样本即得可复用音色,支持语气、语速、停顿的逐段调节,同一音色跨语种输出。
以音素序列反向驱动唇形与下颌,中英混读、方言与日语的口型自然过渡,不靠模板拼接。
输入讲稿即可自动分镜、配字幕、选背景与插入素材,产出结构完整的可发布视频。
表格导入上百条讲稿,一次排队全部出片;改文案只重算受影响片段,不重跑整条视频。
时间轴与素材板同时编辑,评论定位到具体帧,团队与外包在同一份工程里交付。
采集 30 秒 · 人脸对齐中
手机前置镜头录 30 秒,上传后自动对齐光照与视角。音色用 8 句朗读样本重建,一次采集生成专属形象与嗓音,之后所有视频共用。
粘贴文案后系统按语义切段,为每段配上口播、画面与字幕节奏;你也可以锁定某几段不动,只重编其余部分。
把讲稿整理成表格导入,几十上百条视频依次进入队列。产出按规格分目录存放,直接对应各平台的尺寸要求。
成片以预览链接分发,同事在画面上直接标注;确认无误后一键导出,工程与授权记录留档可查。
封面默认是静帧,悬停才拉流播放首段——离开即停并归零,十几张卡片同时挂着也不会抢带宽。
库里每个形象都带可用授权与音色档案,挑中直接写讲稿。你自己的分身只出现在私人空间,不会被列进来。
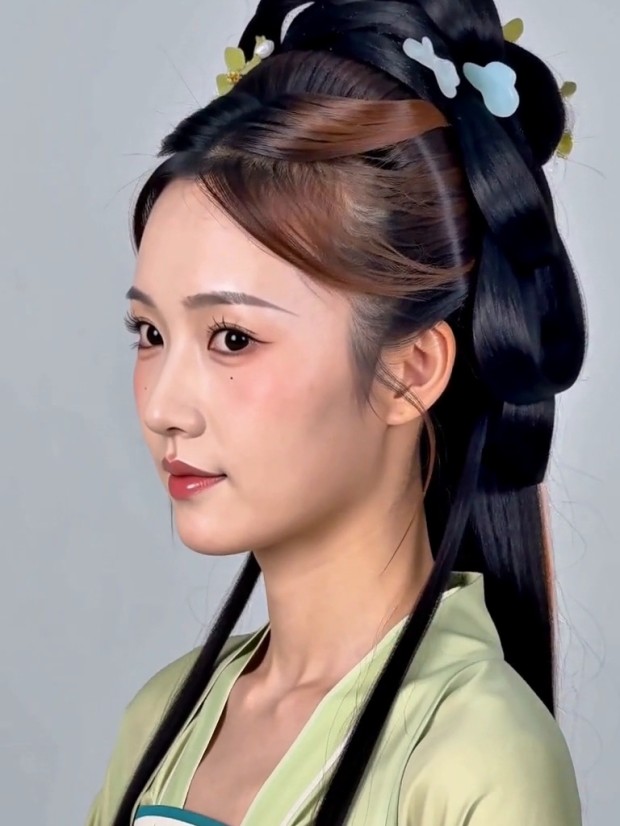 剧情角色柳三娘茶坊老板娘 · 爽利
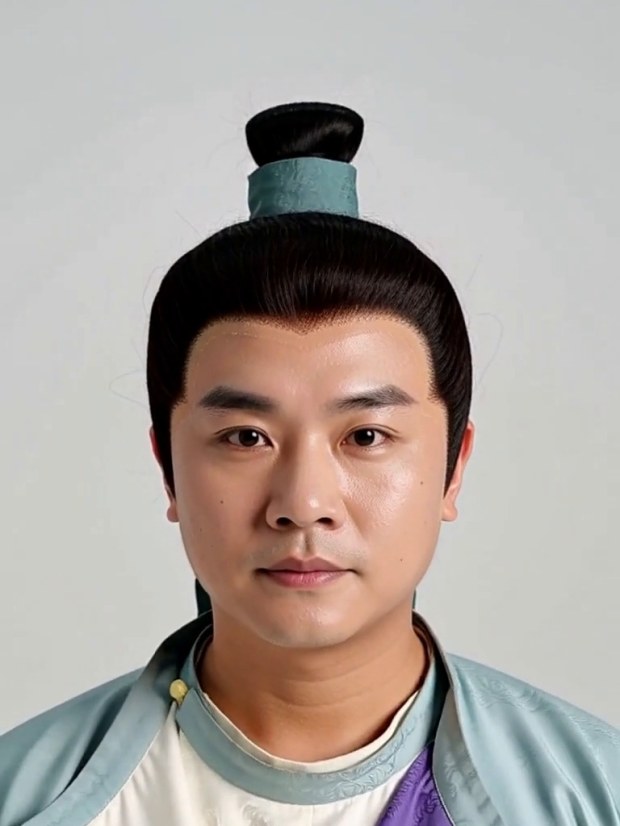 剧情角色苏明年轻账房 · 沉稳
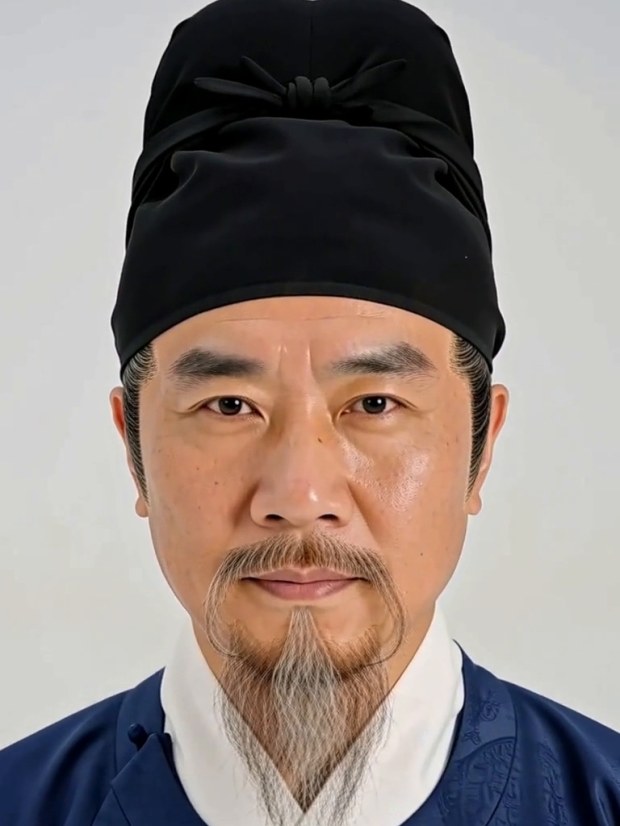 剧情角色钱掌柜掌柜 · 世故
以前一条讲解视频要从早上录到下午,现在讲稿定稿就能进队列,晚上回来已经出完了。
留个邮箱,我们把采集清单发给你,先免费试跑一条。
我们不主动打扰,只发与产出相关的内容。